11月16日,首届蚂蚁灵波具身大模型挑战赛总决赛在上海张江科学会堂落幕。
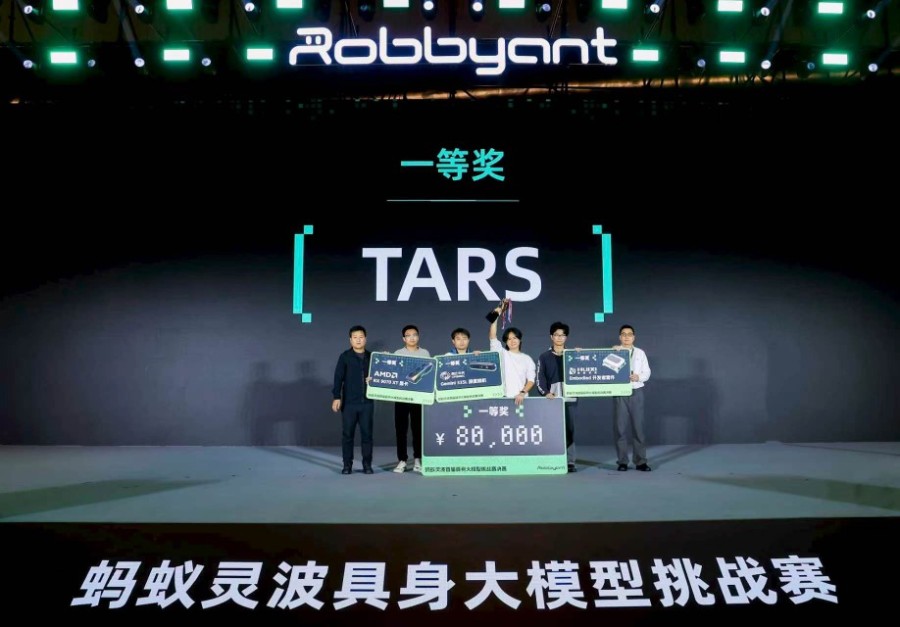
48小时真机比拼后,由福田实验室、西北工业大学、普渡机器人、天津大学五位选手组成的TARS 战队以82.5分夺冠,EVA、SST 两队获二等奖。13个国家、1855支队伍、3252名选手报名,是行业内规模最大的一次具身大模型挑战赛。
冠军团队的五个人平均25岁,队长吴昊楠是天津大学即将毕业的00后硕士。决赛前五个人只是“网友”,没在线下见过面。
两天前,15支队伍集结,9点公布赛题。三道题都很日常:单臂抓果蔬、单臂抓化妆品放进透明盒、双臂配合把垃圾扫进收纳筐。三轮测评取最高一轮,哪一步没做对,分数就没了。
冠军的三处改动:抹背景、换夹法、补下坠
TARS 的路演里,没提什么新算法。吴昊楠说,前两题其实是同一个问题:看准了,拿起来,放到该放的地方。
第一招就是:先让千问把画面里的干扰物逐个打框,再按背景色把框里的东西抹掉。从头部相机看过去,桌上只剩一个干净、清楚的抓取目标。
第三题是双臂配合把垃圾扫进收纳筐,得先夹住铲子。他们发现正位夹的接触面和摩擦力都很小,容易打滑,稍一偏转铲子就翻过去。他们改成夹住后沿,让铲子能稳稳夹住。
末端下沉,他们也单独处理了。手臂伸得越远,往下沉得越厉害,说好的位置实际会低一截,东西就放歪。官方数据里最重的物体只有100克,测不出这下沉。他们拿一瓶500克的矿泉水当砝码去拟合,算出伸多远该补多少,加在推理侧。
只补了13条数据,拿了第三名
SST 战队四人来自天津大学、北大、中国科学院自动化所,他们先让大模型读懂任务指令,圈出要动的那件东西,再把画面里其他东西调暗到几乎看不见。无关杂物被屏蔽,要操作的物体被高亮。
难在教会模型认东西。现成模型在真机上不听话,给指令也圈不准。他们想出个招:把录像倒着放。倒放的头几帧,正好是任务结束时的画面,操作过的物体就在那儿,最好认。让 AI 在那一帧找到物体,再倒回来顺播一遍,整段录像就自动标好了。只额外拍了13条数据,总分排第三。
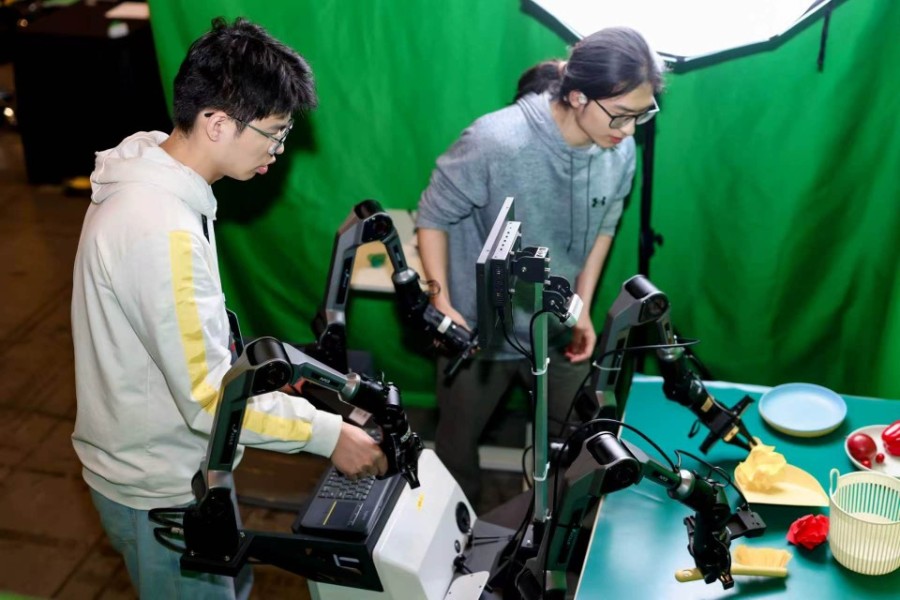
EVA 走另一条路:让机器人自己练,练完看录像,AI 判对错,做错的场景人补拍纠正,再练。七轮补了700多条,成功率从10%提到70%左右,总分7排第二。
一个几乎不补数据,一个拼命补数据,结论一样:赢的不是更聪明的算法,而是数据怎么采、采什么。
有的队伍失分,不在方案,在场地。中国中检旗下一家子公司的战队方案扎实,却排第15,复盘才发现桌子跟别人差了5厘米:机械臂离桌17厘米,别人12厘米,东西摆靠外一点,胳膊就够不着;桌上的透明架子也放不准,让放第三层,它稳稳放到第二层。两个大厂校招生组的“416一定行”,第二天不小心挪了桌子,“练了7000步的模型基本白练”。
蚂蚁灵波发布开发者生态计划
初赛在电脑模拟里成功率就过了70%,为什么还要拉到真机上比48小时?蚂蚁灵波负责市场运营与技术生态的江波说,让一个模型真正落到机器人上,还有很多问题要在实践里回答:机器人装到不同的机器上还能不能跑;换个任务还灵不灵——三道题用的还是同一个模型,考的就是它不是只会一件事;从采数据到调好模型再到装进机器,48小时能不能走完一遍;时间这么短,出了问题能不能马上找到、马上解决,也是比赛要看的能力。
上海交大副教授李永露把这场比赛叫“控制变量实验场”:每一次抓取失败的边界条件、每一组精准校准的补采数据、每一次模型调优后的实测反馈,都能为后来者减少试错成本,推动机器人“通用大脑”走进下一个真实的物理现场。
同一天,蚂蚁灵波发布开发者生态计划:请20位“最有价值专家”,主要面向高校老师和科研人员,把课上怎么教、实验怎么做整理成课程和案例;招40位“开发者专家”,面向一线开发者和写技术内容的人,做demo、开源工具,或写教程、答疑。入选者可获课程开发支持、与研发团队定期交流、课题合作与联合实验室优先对接。
江波说:“让每一次实践成为更多人的起点。”这也是发布生态计划的初心。在她看来,一次模型实践的价值不只在项目本身,“它也可以成为一门课程、一个应用、一份研究成果”。
文、图/广州日报新花城记者:陈庆辉 林晓丽
视频/广州日报新花城记者:陈庆辉 林晓丽
广州日报新花城编辑:龙嘉丽


 打开广州日报新花城,享受流畅体验