大模型能不能上岗做销售?网易智企近日发布《2026销售场景AI实战评测报告》给出的答案是:能承接具体任务,但还到不了“替代销售”。企业AI落地的下一阶段,不再只是选模型,而是把模型能力、业务知识、规则和流程连起来——先有任务标准,再有模型选型,最后让AI在真实业务里持续跑下去。
从“哪个模型最强”转向“哪个任务用哪个模型”
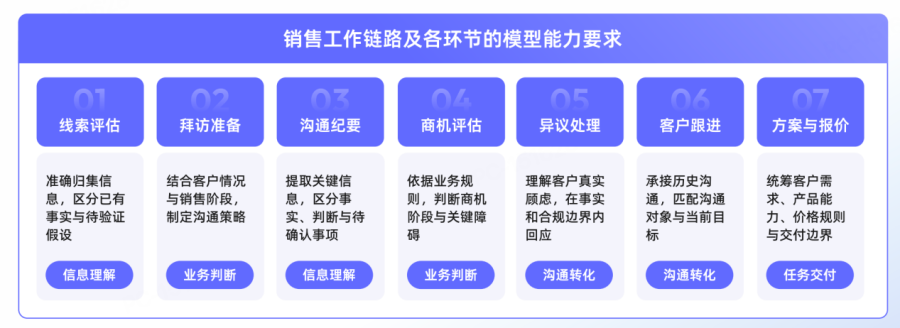
作为国内首份聚焦企业真实销售场景、以任务交付为验收标准的大模型深度评测,报告将12款国产大模型放入真实销售工作流中,围绕线索评估、拜访准备、沟通纪要、商机判断、异议处理、客户跟进、方案与报价7项高频销售任务展开实测,共形成420份实际工作成果。
据悉,本次评测覆盖DeepSeek、MiniMax、豆包、千问、Kimi、GLM六个品牌共12款模型。所有模型统一在网易智企企业级AI Agent平台帝王蟹(ClawHive)中运行,由销售宝承接具体销售工作,确保同一任务下各模型获得相同的业务输入、规则约束和交付规范。
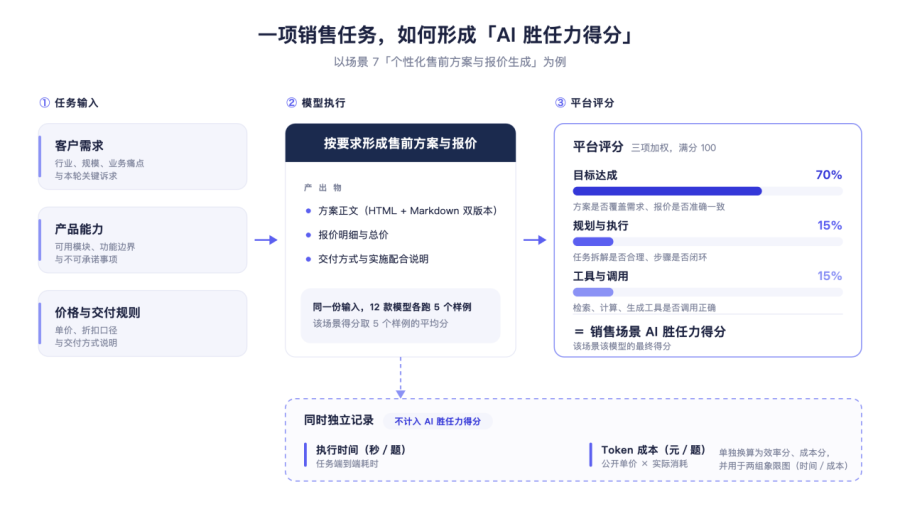
报告提出“销售场景AI胜任力”评价框架:目标达成占70%,规划与执行占15%,工具与调用占15%;执行时间与Token成本单独记录、不计入总分。报告刻意不设统一加权总分,也不评“全能总冠军”——因为真实销售工作里,不同任务对模型能力的要求本就不同。
结果显示:
· Qwen3.8-Flash 在拜访准备、沟通纪要、异议处理、方案与报价4项任务中位列第一;
· DeepSeek-V4.1-Flash 在线索评估、商机评估、客户跟进3项任务中领先。
得分高≠更适合:质量、速度、成本要分开算
评测进一步揭示,模型表现与调用成本、响应速度之间并无简单正相关。
以商机评估为例:DeepSeek-V4.1-Flash得88.42分,Qwen3.8-Flash得87.17分,分差仅1.25分;但后者每题Token成本约0.0384元,比前者低约57.1%。对周期性批量处理、时效宽松的场景,成本优势更值得考虑。
到了异议处理则反过来:Qwen3.8-Flash得分高5分,但平均执行时间约101秒;DeepSeek-V4.1-Flash仅需约29秒,快约71.5%。销售正与客户沟通、临时要一句回应思路时,速度可能比几分差距更关键。
单次调用不够,业务上下文才是落地门槛
值得注意的是,真实销售不是7道互不相关的考题。一次沟通形成的需求、预算状态和待确认事项,会进入商机判断;商机缺口决定下次跟进问什么;方案报价又要回扣产品能力与价格规则。
从评测结果来看,沟通纪要场景最能拉开差距:Qwen3.8-Flash得89.58分,Qwen3.8-Max得82.75分,差6.83分,是7项任务里前两名分差最大的一项。
难点在于“事实边界”——客户说“内部已立项”,不能直接写成“预算已批”;“七月底要定下来”也不能自动等同于“确定签约”。一旦纪要记错,错误信息进入CRM,会延续到后续商机、跟进与报价环节。
这意味着企业真正需要的不是“会写字的模型”,而是能理解自家客户资料、产品版本、报价规则,并让成果接续到下一环节的AI能力。
选对模型之后,还要让AI懂业务。企业需要的不是一款处处最强的模型,而是让每项任务都能调用更合适的模型能力。
文/ 广州日报新花城记者:倪明
广州日报新花城编辑:李光曼

 打开广州日报新花城,享受流畅体验