大语言模型的能力,已经在海量文本训练与规模化扩展中得到验证。它之所以能够持续强化,一个重要基础是:海量来自书籍、网页还是对话的知识,最终都能被统一到“文本”这一输入输出空间中,模型才能在其中完成学习、组合与迁移。那么,具身智能能否找到一条类似路径?机器人如何从不同来源的经验中学习,让感知、动作与物理世界的变化形成统一理解?走向 Physical AGI,它的“原生统一空间”又应该是什么?
10月12日,跨维智能(DexForce)发布全球首个机器人任务原生3D世界模型UNITAS(A 3D-Native World Action Model for Embodied Manipulation),探索为Physical AI建立统一表示空间的新路径。
UNITAS提出的核心观点是:只有让模型原生理解三维物理世界,世界模型才真正接近“世界”本身。
那如何让机器人在三维世界里理解“动作”与“变化”?机器人真正进入物理世界,面对的不只是“如何行动”的问题,也包括“行动之后世界会如何变化”。
传统机器人策略模型关注的是:机器人下一步应该执行什么动作;而世界模型关注的是:执行这个动作后,环境会发生怎样的变化。过去,这两个问题通常被作为不同任务分别建模,但从真实物理过程来看,二者本质上是一件事。
当机器人伸手拿起一个杯子时,机械臂移动是动作,杯子离开桌面并发生位移是结果,两者共同构成了一次完整的物理交互过程。机器人如果只学习“怎么动”,却不了解动作会如何影响世界,就很难真正理解物理规律。
UNITAS提出的核心思路,正是将观察、行动和世界变化统一到同一个三维物理空间中建模。
也许你会好奇,机器人领域已经有不少方法引入了三维信息。而UNITAS的“3D原生”(3D-Native)是直接让模型在三维物理空间中学习世界。简而言之,“世界”模型直接作用在统一坐标系下的三维Token上,而不通过图片Token作为桥梁。
例如,机器人执行“拿起杯子”任务时,模型不仅需要知道杯子在哪里、机械臂应该如何移动,也需要理解夹爪靠近、抓取、抬起过程中,杯子的位置如何变化,以及整个场景将如何响应。
UNITAS用三维点的轨迹描述这个过程:动作流(Action Flow):人手或机器人夹爪上的点如何随时间移动。场景流(Scene Flow):以这些点为条件,杯子等场景中的点如何移动。在UNITAS中,这些过程不再被拆分成多个独立问题,而是在同一个三维坐标系中进行联合建模。因此,模型既能够根据任务目标生成可执行动作,也能够根据动作预测未来的世界变化。
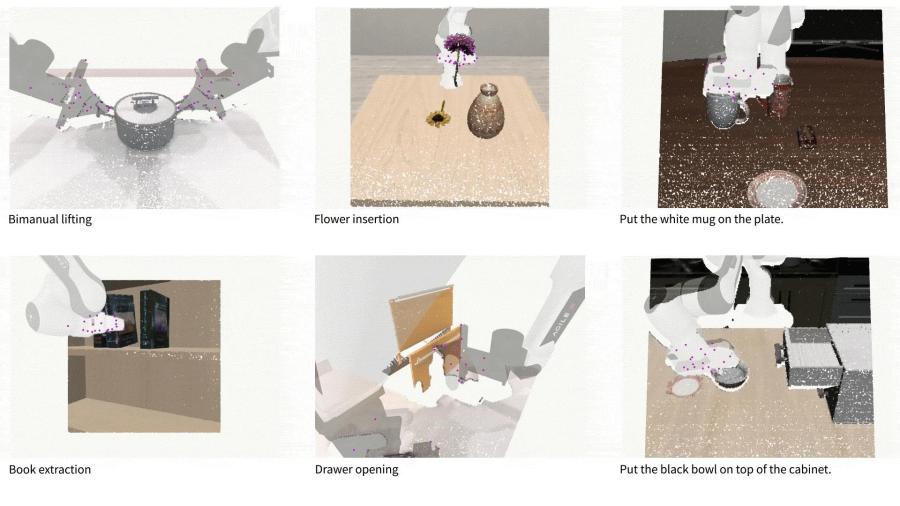
预测的动作流以及对应的场景流
只有让模型原生理解三维物理世界,世界模型才真正接近“世界”本身。该观点不仅是一个技术思路,UNITAS已在多项机器人操作评测中展现出了实力:仅凭1.7B(17亿)参数,在LIBERO上取得99.8%的平均成功率、在LIBERO-Plus上达到89.1%,并在RoboTwin 2.0双臂操作的Clean与Randomized设置中分别取得92.94%和93.04%的成功率,超越参数规模达6B(60亿)的Fast-WAM、8B(80亿)的Motus,以及π0.5、LingBot-VA、PointWorld等模型,在多项基准测试中全面夺冠,进一步在真实机器人操作执行上同样表现突出,任务平均成功率达到85%。
未来,跨维与全球开发者、产业伙伴携手,让机器人真正理解物理世界,并在持续学习与进化中走向更广泛的应用,推动具身智能成为下一代生产力的重要组成部分,让机器人逐步走进更多生产与生活场景,服务千行百业,创造更广泛的价值。
文/广州日报新花城记者:张露
广州日报新花城编辑:李光曼

 打开广州日报新花城,享受流畅体验