摘要丨谁在给具身智能“注水”?
9月10日,邵天兰的朋友圈,往具身智能圈投下一颗深水炸弹。这位刚登陆港交所的“具身智能眼脑手第一股”梅卡曼德创始人兼CEO,实名吐槽“攒局型”具身智能企业,并在评论区点名银河通用。
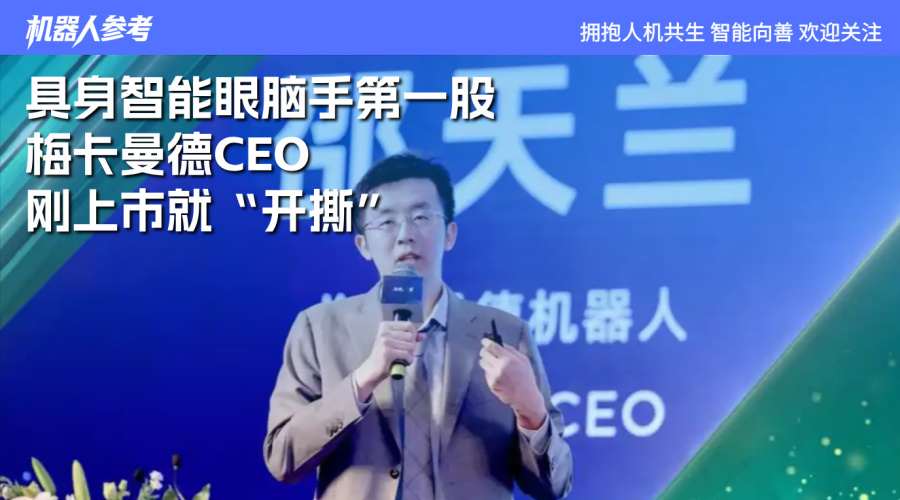
他的措辞毫不客气:大量企业利用“数采中心”以及关联交易制造虚假、不可持续的收入,成立两三年就急于冲刺上市,这套操作“不合法、不道德,而且是不聪明”,最终会坑害广大投资者。当晚,银河通用公众号发布《具身智能是一场长跑,我们只与时间赛跑》,以克制姿态作出回应。
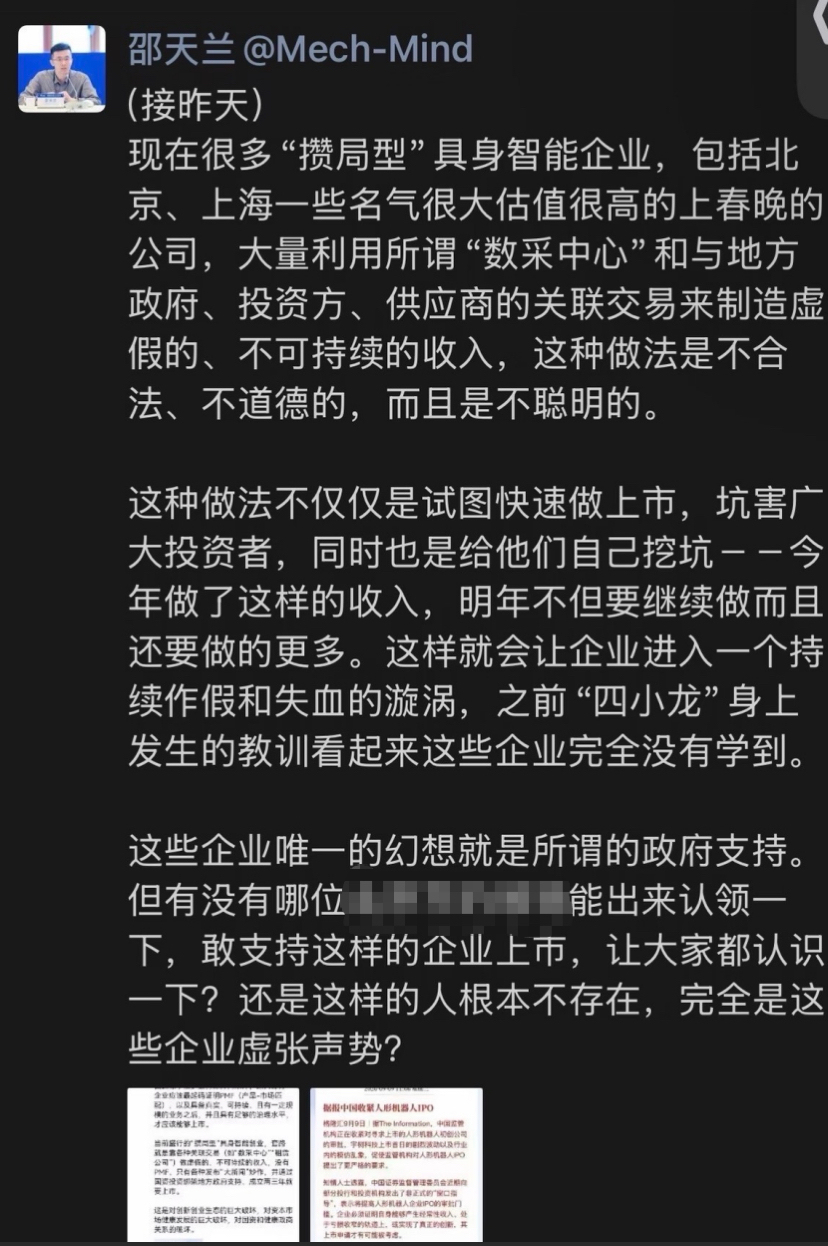
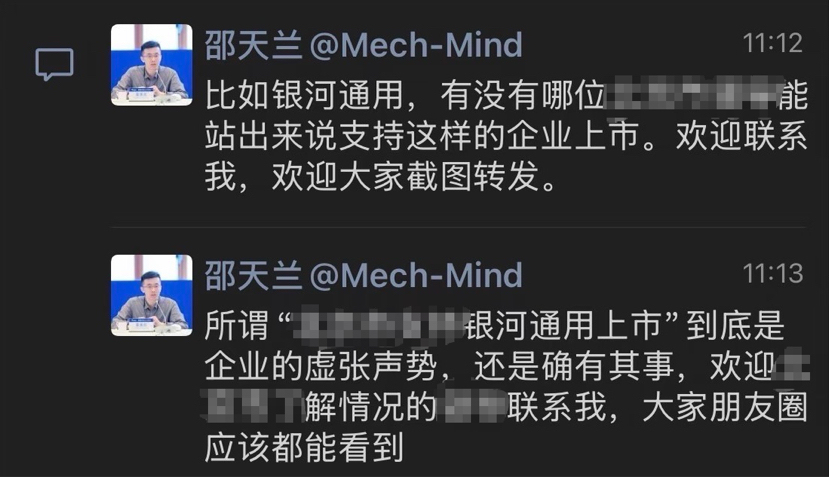
源自网络
有人认为邵天兰在公开舆论场上批评同行是不讲武德,也有人赞他是“嘴替”。至于他的动机,外界揣测不一:他多次讲“Play no trick”,对“攒局”有本能反感;梅卡曼德刚上市、尚未扭亏,若行业继续靠“攒局”堆收入,一旦暴雷,整个板块信任被透支。公开划清界限,既是价值主张,也难免有市值管理意味。
但大部分业内人士都清楚,邵天兰撕开的,是行业早就心知肚明、看破不说破的那层遮羞布。
过去一段时间,笔者密集参加了世界人工智能大会、机器人大会的多场论坛和业内交流,也和模型厂商、本体厂商、数采硬件厂商的人聊了很多。大家私下里的共识是:数采这件事,从底层逻辑、体系设计建设到落地执行,都离标准化太远,极其混乱。但很少有人愿意公开说,当前支撑整个具身智能产业发展根基的数据链条,正在暴露出深刻的结构性矛盾。邵天兰提了,于是圈子炸了。
趁着这波关注,笔者把之前调研和留意到的数采乱象,集中分享如下。
数据确实是燃料,但采出来的可能是水
“智能的本体是存在于数据里面的。”自变量创始人兼CEO王潜日前在外滩大会上抛出了一个有代表性的判断:“(相较于数据),模型更多扮演‘蒸馏器’和‘容器’的角色,训练时提炼数据中的能力,部署时承载这些能力。”
数据与模型的关系,是一个飞轮:模型定义数据需求,数据反哺模型上限。和大语言模型不同,人形具身机器人无法仅靠互联网文本数据学会抓取、触碰、作业等物理交互能力。这些能力的底层数据,目前最接近“金标准”的来源仍是真机在真实物理世界中的交互采集,尤其是包含视觉、触觉、力觉和动作的多模态数据。问题在于,真机采集成本高、难规模化,仿真与合成数据因此成为补位手段,但距离替代真机数据仍有距离。
在今年的WAIC、WRC上,智元姚卯青等许多业内大佬的一致观点是:想要实现具身智能的能力涌现,离不开亿级规模的高质量物理交互数据。当前全行业的普遍口径,是当下沉淀下来的有效高质量数据,仅仅处在几十万到百万小时量级。
于是,巨大且关键的指数级数据缺口横亘在产业面前。
缺口之下,一股近乎狂热的“数据崇拜”席卷赛道。不少从业者在对外交谈中,默认一套简单的“大力出奇迹”的逻辑:只要砸钱、铺设备、建数采中心,不断拉高采集总时长,通用人形机器人的商业化曙光就会自动到来。
但很少有人公开追问一个核心问题:数采中心、真实工厂、零售场景中采集的这些数据,就等同于高质量可用数据吗?数据量越大,模型效果就越好吗?
综合多家模型厂商的内部测试与反馈,现实给出的答案普遍比较冰冷:并非如此。
笔者调研中,部分企业分享的实测数据显示,首先真正能够清洗标注后送入训练流程的数据,只占原始采集总量的10%到20%;新增数据在模型训练早期,能推动效果近乎指数级提升,可一旦采集量跨过某个阈值,边际效益就会快速跳水,后续新增的采集数据对模型迭代几乎没有实质增益。
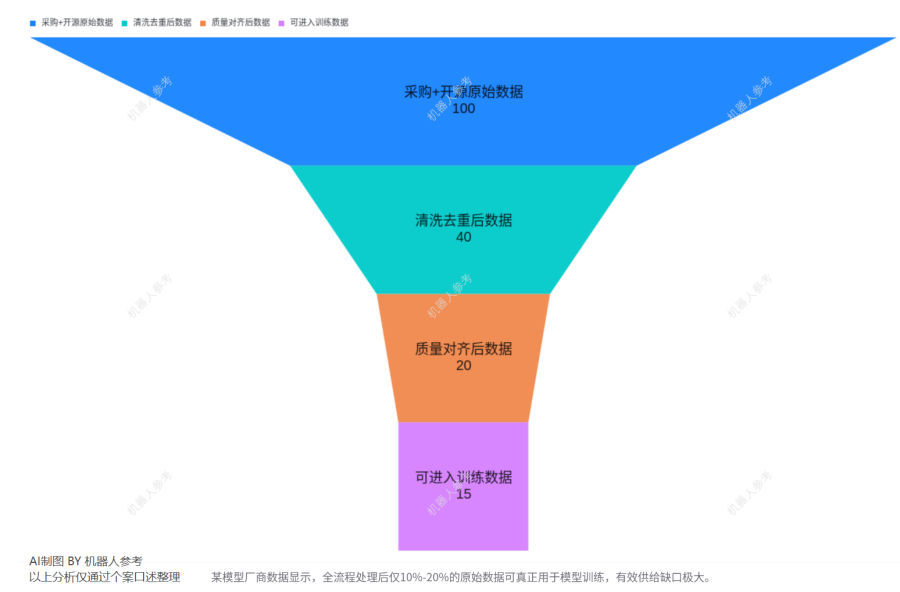
为何名义供给与有效供给之间,横亘着一道如此巨大的鸿沟。也许根子出在底层采集逻辑的错位。
数采的体系建设,没有共识和标准答案
当前,数据采集的产业链已形成一条清晰链条:上游硬件厂商提供头戴、腕部相机等设备;中游是数据清洗、标注平台;再交给数据运营公司,组织人员深入工厂、餐饮、零售等场景实地采集;采集完成后的数据销售给大模型企业;大模型利用数据集完成训练,再把模型部署到机器人本体。

链条的底层逻辑看似合理,执行层面却非常混乱。
第一,采集目标不明确。当前普遍优先批量化复刻机器人可执行、易执行的动作,而模型亟需的故障、极端工况等数据供给稀缺。模型、机器人厂商也难以提前明确数据需求,往往要等训练、测评、部署失败后,才能定位缺口,再反向调整采集SOP。形成滞后甚至断裂的反馈逻辑。
第二,数据难以转化为可复用的有效资产。数据和各类机器人本体无法深度耦合,A机器人采的数据,换到B机器人上直接导入,就会干扰模型精度。真机自己采集、自己训练、自己反馈,是目前最理想的路径,但有能力自建闭环的头部大厂才负担得起。对绝大多数中小厂商而言,既没有能力自建闭环,又必须依赖外部数据。某创企CEO直言,“好数据的标准每天在变”“跨本体数据直接混训效果一塌糊涂”。这就形成了一个怪圈:数据越来越多,真正能跨主体复用的有效数据资产却少得可怜。
第三,采集场景脱离实际,也是通病。现有采集场地多为标准化样板间,过滤了物理环境、操作误差等真实变量,仅适用于冷启动阶段。在前期数据训练中,模型基础能力快速提升了,但持续重复采集同质化、理想化的场景数据,无法给模型提供新的学习样本。
第四,更深的混乱在于,数据配方根本没有标准答案。在多个圆桌环节,行业对于“配方”的配比各执一词:有说无本体数据应占约90%、真机约10%;也有观点提到,真实数据几百小时、合成数据几千小时、人类数据几万小时,才算合理配比;还有观点强调,数据来源、筛选方式和采集人数,比绝对小时数更重要。
仿真数据的价值,更是最大的非共识。有从业者称“完全放弃第二层仿真/合成数据”,认为仿真器像小模型,生成数据训大模型不合理;也有人直言“仿真标不出真实世界的摩擦”;但另有观点对高真实仿真工具链寄予厚望,认为规模化验证需更依赖仿真评测。
数采中心建设主体同样混乱。一派认为,模型公司必须自建中试数据工厂、定义SOP,再众包放大;另一派则认为,数采运营的终局落点于大规模人力运营商如美团、京东,大脑公司只聚焦数据标准定义。此外,计价方式按采集时长结算仍是主流,但数据对模型的实际增益难以精准归因,大部分交易更像一单一单定价的项目外包,无法实现标准化采购。
更隐蔽的乱象从源头供给端就开始产生。早年间,人形机器人数据采集高度依赖真机遥操作,单套本体设备成本动辄二三十万元,高昂成本把绝大多数高校和中小创业团队挡在门外,数采几乎是头部大厂的专属能力。
今年以来无本体穿戴式采集方案涌现后,硬件成本下探至万元甚至千元级别,理论上能降低门槛,让更多市场主体参与物理数据生产。但数采的核心难点并不在“有没有设备”,而在设备能否实现多模态信息的时间对齐:人眼看到的画面和手部抓取动作是同一时刻发生的,如果头戴相机、腕部相机、触觉手套时钟不同步,视觉和动作时间戳错位,整套数据就失去训练价值。
当前数采上游的硬件供给端的方案五花八门。比如头戴式采集设备双目、四目、六目、八目方案并存,行业连“到底需要几路摄像头”都没定论。大量初创企业快速搭出无本体数采demo样机来找合作,但量产交付能力严重不足,良率、供应链稳定性都难保障。还有新玩家以为双目相机门槛低,直接买安防模组拼装,结果色彩不一致、结构一碰就漂,数据直接报废。
如此种种,不一而足。换个角度看,这是行业高速飞驰、百花齐放、盛况空前的缩影。
说在最后——
从无序的当下,奔向健康的未来
过去一年,国内隐秘落地约百个数采中心,撑起了漂亮的财务数据。根据行业研究机构InteractAnalysis截至2026年4月底的统计,中国至少90个人形机器人数据采集和训练中心处于使用或规划建设中,64个已正式投入运营,仅2026年一季度就新增28个。
但闲置与离场在同时发生。北京首个人形机器人数据训练中心——石景山首钢园数采中心,成立仅17个月后停摆,核心合作方睿尔曼智能正式撤出。项目方解释为1.0升级为2.0:从集中式、布景式采集,转向工厂产线、仓储物流的真实作业采集。
用迭代可以合理解释为何停掉旧版本,却不能正面回答一个更硬的问题:数采中心作为一门生意,如何让机器人采购、数据回购、运营补贴不只是在同一生态内循环?如何真正走向健康、可持续的协同发展模式?这个问题,不只针对数采中心项目,也是整个具身智能行业从无序走向成熟必须跨过的一道坎。
监管端已经有动作。据科技媒体The Information报道,证监会近期向部分投行和投资机构发出非正式窗口指导,拟提高人形机器人初创企业的IPO审批门槛。与此同时,北交所二季度以来上会企业的问询中,经营业绩的真实性与可持续性已成为“标配”,收入确认、客户稳定性、毛利率波动被反复追问。这套风控升级,让“成立两三年就上市”的叙事越来越难实现。
但这不意味着行业在降温。恰恰相反,具身智能仍在飞速进步,3个月相当于其他行业一年的发育节奏,数据、模型、本体、应用、资金、政策都在蓬勃生长。问题在于,产业真实而艰难的落地进展与资本超高期待之间落差始终巨大。监管收紧,短期是约束,长期是倒逼行业健康发展。
接下来,不管是卖铲子、卖本体还是卖大脑,资本再热、递表节奏再快,都躲不过同一场大考:真刀真枪,拿真实业绩来说话。
注:本文基于采访资料及论坛录音整理,仅为个人观点,不构成投资建议。欢迎指正。
文、图/广州日报新花城记者:阮元元
广州日报新花城编辑:何波

 打开广州日报新花城,享受流畅体验